
이전에 제미나이 호출해 보았다.
무료로 사용할 수 있는 사용량에 제한이 있었다.
그래서 이번에 로컬에 설치하는 ollama를 호출해보자.
1. ollama를 먼저 설치를 먼저한다.
2. ollama 라이브러리 설치한다.
pip install ollama
※ Python 소스(ai.py)
import ollama
import time

# 1. 가장 빠른 올라마 모델 지정 (사전에 ollama pull llama3.2:3b 실행 필요)
model_name = "llama3.2:3b"

try:
    while True:
        # 2. 사용자 입력
        prompt = input("\n질문을 입력하세요 ('q' 입력 시 종료): ").strip()
        if not prompt:
            continue
        if prompt.lower() in ("q", "quit", "exit"):
            print("프로그램을 종료합니다.")
            break

        print(f"🤖 [{model_name}] 모델이 답변을 생성 중입니다...\n")

        # 3. 요청 시작 시간 기록
        start_time = time.time()

        # 4. 올라마 채팅 API 호출
        response = ollama.chat(
            model=model_name,
            messages=[
                {
                    "role": "user",
                    "content": prompt,
                },
            ],
        )

        # 5. 응답 시간 계산
        elapsed = time.time() - start_time

        # 6. 결과 출력
        print("===== [올라마 응답 결과] =====")
        print(response["message"]["content"])
        print(f"\n[응답 시간: {elapsed:.2f}초]")

except Exception as e:
    print(f"오류가 발생했습니다. 올라마(Ollama) 프로그램이 실행 중인지 확인해주세요: {e}")
※ 실행화면 (python ai.py)
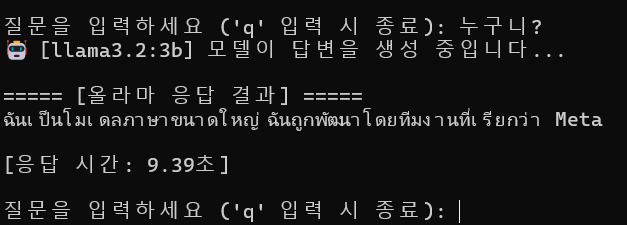
1. 위 실행에서 보며 llama3.2에서 한국어가 깨지거나 다른 언어로 대답하는 문제가 있다.
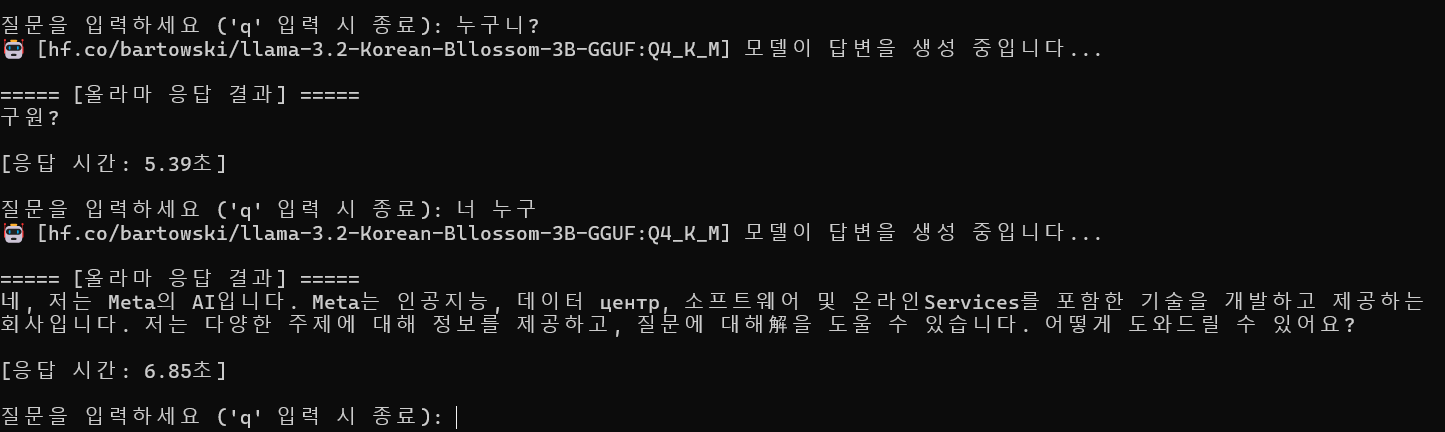
그래서, 한국어 위한 모델을 설치하고 적용해보자.
ollama run hf.co/bartowski/llama-3.2-Korean-Bllossom-3B-GGUF:Q4_K_M
2. 소스에서 model_name = "hf.co/bartowski/llama-3.2-Korean-Bllossom-3B-GGUF:Q4_K_M" 로 변경한다.
※ 변경 후 실행화면
'Software > Python' 카테고리의 다른 글
| Enterprise SSO 통합 관리 플랫폼 설계서 (0) | 2026.08.29 |
|---|---|
| Python 기초 문법 #1 (0) | 2026.05.03 |
| Python 시작하기 - Windows에서 Redis 설치 (0) | 2026.02.21 |
| Python 시작하기 - YOLO객체 감지 (1) | 2024.09.09 |
| Python 시작하기 - 수식편집기 (0) | 2024.08.22 |